한줄 요약
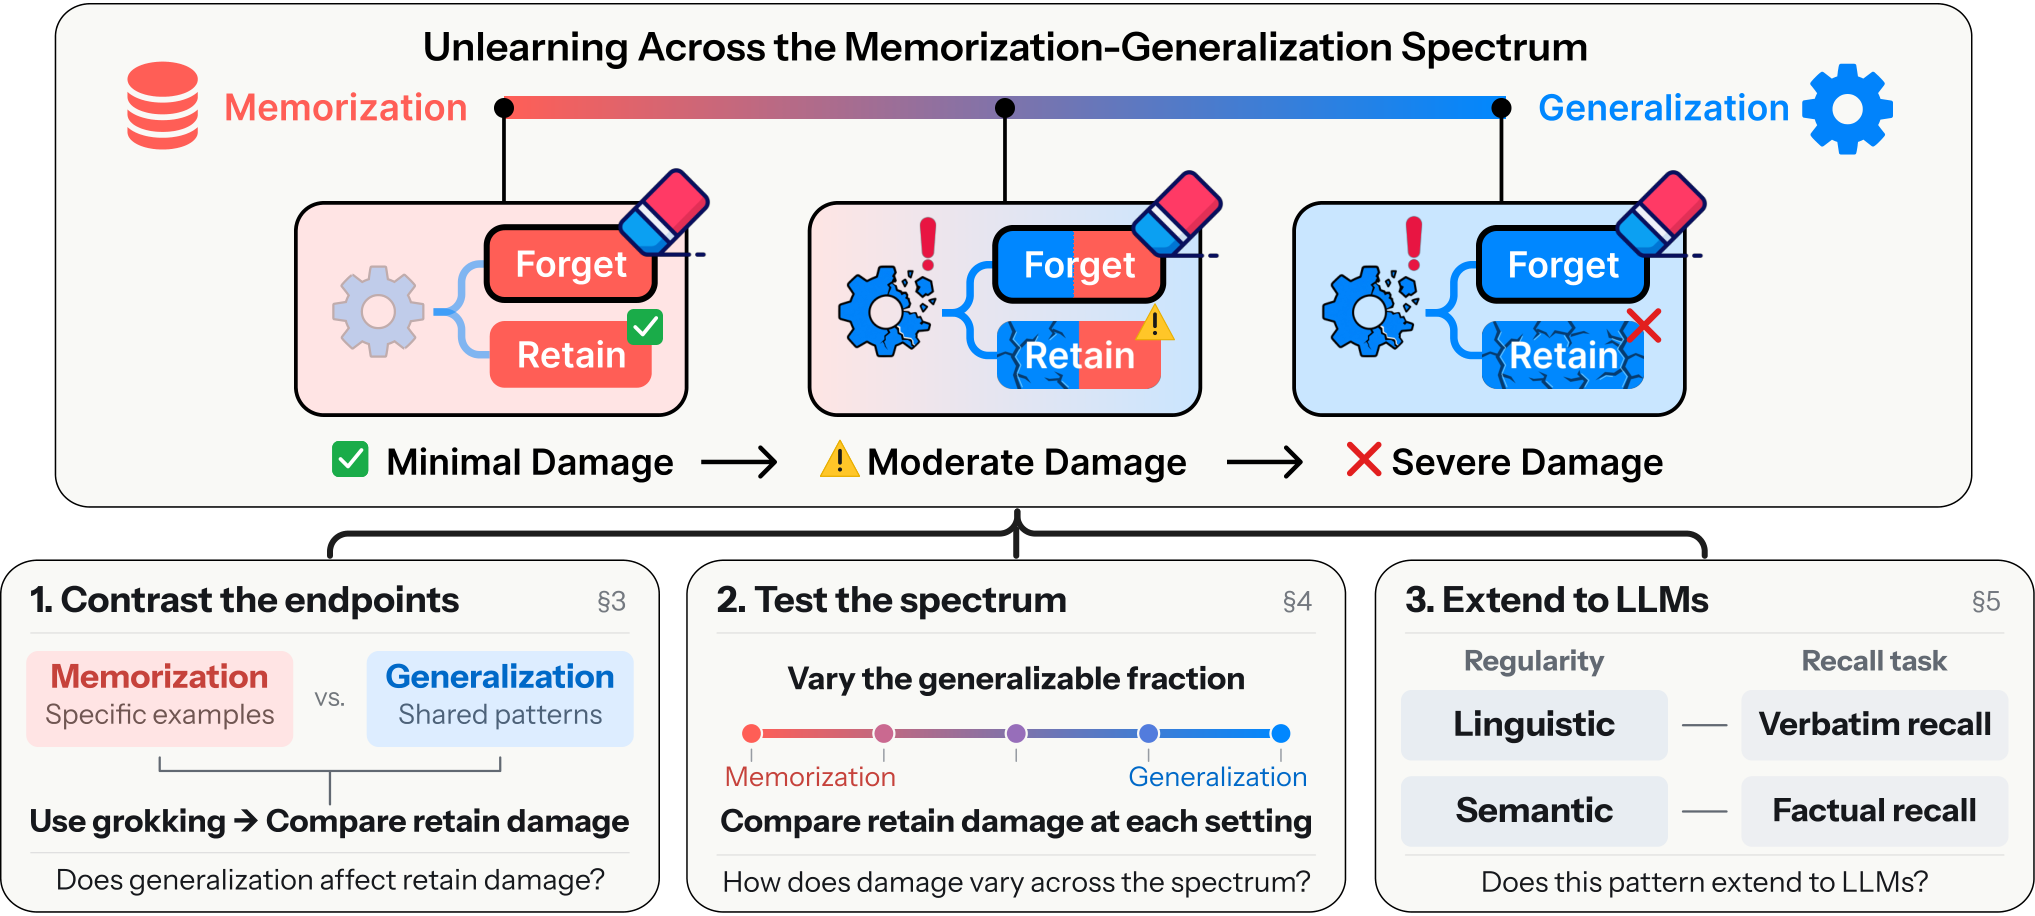
모델이 어떻게 학습했는지가 어떻게 언러닝되는지를 결정한다는 것을 보여줍니다. 모델이 암기(memorization, 샘플별 정보)보다 일반화(generalization, 공유된 해결 메커니즘)에 많이 의존할수록 언러닝이 유발하는 보존 손상(retain damage)이 커집니다. 그로킹된 모듈러 덧셈에서 암기 모델은 언러닝 후 59.5%의 보존 정확도를 유지하지만 일반화 모델은 8.1%만 유지하며, 새롭게 제안한 버킷 모듈러 덧셈(BMA)에서는 이 경향이 스펙트럼 전반에 걸쳐 거의 단조적으로 나타납니다(Spearman ρ −0.9 ~ −1.0). 동일한 관계가 Hubble-8B LLM의 원문 재현(verbatim recall)과 사실 재현(factual recall)에서도 확인됩니다.
배경 및 동기
LLM과 같은 사전학습 모델은 데이터 소유자가 나중에 삭제를 요청할 수 있는 개인정보나 저작권 자료를 학습 과정에서 흡수합니다. 머신 언러닝(machine unlearning)은 이러한 삭제 세트(forget set)에서 학습된 지식을 제거하면서 보존 세트(retain set)에 대한 성능은 유지하는 것을 목표로 합니다. 그러나 실제로 기존 방법들은 이 균형을 거의 달성하지 못합니다. 망각에는 대개 무관한 지식과 능력의 부수적 손실이 동반되며, 본 논문은 이를 보존 손상(retain damage)이라 부릅니다.
신경망은 두 가지 경쟁적인 전략으로 데이터를 학습합니다. 암기는 개별 학습 예제에 묶인 정보를 저장하고, 일반화는 여러 예제에 공통으로 적용되는 공유된 해결 메커니즘을 학습합니다. 저자들은 이 둘을 암기–일반화 스펙트럼의 양 끝점으로 간주하고, 기존 언러닝 연구가 대체로 간과해 온 질문을 던집니다: 모델이 이 스펙트럼에서 어디에 위치하는지가 언러닝이 유발하는 손상의 크기를 결정하는가?
핵심 가설: 언러닝은 학습을 되돌리려는 시도이므로, 모델이 데이터를 학습할 때 사용한 전략이 이후 언러닝에 얼마나 쉽게 반응할지를 결정해야 합니다. 삭제 세트와 보존 세트가 동일한 공유 메커니즘으로 풀린다면, 삭제 세트를 억제하는 것은 반드시 그 메커니즘을 훼손하여 보존된 예측에도 손상을 입힙니다. 반면 암기된 예제는 개별적으로 제거할 수 있어 부작용이 작습니다.
실질적인 장벽은 모델의 정확한 스펙트럼 위치를 직접 관측할 수 없다는 점입니다. 따라서 본 논문은 다루기 쉬운 대리 지표들을 단계적으로 도입합니다: 모듈러 덧셈에서의 그로킹 전이(명확한 이분법적 구분), 필요한 암기량을 설계 단계에서 고정할 수 있는 통제 가능한 과제, 그리고 실제 LLM을 위한 비의도적 암기(unintended memorization)의 정보이론적 추정치입니다.
제안 방법: 분석 프레임워크
본 연구는 점진적으로 현실에 가까워지는 세 가지 설정으로 구성되며, 그 결과로부터 도출된 두 가지 실용적 개입이 뒤따릅니다.
실험 결과
그로킹: 우연 수준 삭제 정확도 도달 시 보존 정확도 (%)
| 단계 | 에폭 | RL | GD |
|---|---|---|---|
| 암기 | 1,000 | 59.5 ± 3.3 | 23.0 ± 6.5 |
| 회로 형성 | 3,800 | 52.4 ± 7.3 | 19.3 ± 5.3 |
| 정리(cleanup) | 10,000 | 14.2 ± 1.5 | 8.7 ± 3.2 |
| 그로킹(일반화) | 25,300 | 8.1 ± 0.7 | 3.3 ± 1.0 |
5개 삭제 세트 시드에 대한 평균 ± 95% 신뢰구간. 네 체크포인트 모두 학습 정확도 100%이며 학습 전략만 다릅니다.
푸리에 회로 보호 시 보존 손상 감소 (그로킹 모델, RL)
| 개입 | 보존 정확도 (%) | FVE | 제한 손실 |
|---|---|---|---|
| RL | 8.1 ± 0.7 | 0.186 ± 0.026 | 2.324 ± 0.183 |
| RL + 필터링 (비핵심 주파수) | 8.2 ± 0.7 | 0.187 ± 0.027 | 2.316 ± 0.187 |
| RL + 필터링 (핵심 주파수) | 30.6 ± 4.1 | 0.509 ± 0.020 | 0.167 ± 0.167 |
원문 재현: P̄f = 0.1에서의 ID 보존 손상 (Hubble-8B, 퍼센트포인트 ↓)
| 모델 | 삭제 세트 | GA | GD | NPO | CEU |
|---|---|---|---|---|---|
| Hubble-8B-100B | High (높은 하한) | 45.5 ± 3.8 | 17.3 ± 2.3 | 45.0 ± 3.8 | 54.2 ± 6.5 |
| Low (낮은 하한) | 54.0 ± 3.2 | 17.9 ± 1.8 | 52.8 ± 3.3 | 74.0 ± 5.1 | |
| Hubble-8B-500B | High (높은 하한) | 14.8 ± 2.1 | 0.2 ± 0.6 | 13.4 ± 2.1 | 44.1 ± 6.1 |
| Low (낮은 하한) | 26.4 ± 2.9 | 3.6 ± 1.1 | 25.2 ± 2.9 | 63.1 ± 4.2 |
High / Low 삭제 세트는 Gutenberg Popular 80개 지문 중 추정 암기 하한 기준 상위 / 하위 30%입니다(예: Hubble-8B-100B에서 1136 vs. 881비트). GD의 보존 항은 ID 그룹 자체에 고정되어 있어 ID 항목은 공정하지 않은 기준선입니다.
사실 재현: 암기 하한과 동일 관계 내 보존 손상 (Hubble-8B-100B)
| 관계 | 암기 하한 (비트) | 동일 관계 손상 (pp) | 타 관계 손상 (pp) |
|---|---|---|---|
| 이메일 | 0.93 ± 0.64 | 45.7 ± 40.8 | 3.0 ± 1.1 |
| 국적 | 1.61 ± 0.44 | 40.7 ± 16.3 | 3.2 ± 0.7 |
| 출생지 | 4.30 ± 2.05 | 16.4 ± 13.1 | 1.6 ± 0.6 |
| UUID | 5.00 ± 0.62 | 13.6 ± 2.3 | 0.9 ± 1.1 |
손상은 삭제 정확도 10% 시점의 정확도 감소량으로, GA, GD, NPO, DPO에 대해 평균한 값입니다. 이메일 주소는 이름 기반 형식(예: Maurice Clauss → clauss@gmail.com)을 따라 대부분 예측 가능하지만, UUID는 무작위이므로 암기해야 합니다.
버킷 내 재분배가 보존 성능을 유지 (BMA, RL, 삭제 정확도 10%)
| p | M | 재라벨링 타깃 | 보존 정확도 (%) | 삭제 버킷 정확도 (%) |
|---|---|---|---|---|
| 131 | 2 | 제한 없음 | 15.4 | 12.5 |
| 131 | 2 | 버킷 내 | 75.7 | 99.9 |
| 277 | 4 | 제한 없음 | 28.0 | 14.7 |
| 277 | 4 | 버킷 내 | 71.3 | 99.7 |
- 일반화 모델은 망각에 훨씬 큰 대가를 지불: 우연 수준의 삭제 정확도에서 암기 체크포인트는 59.5%(RL) / 23.0%(GD)의 보존 정확도를 유지하지만 그로킹 모델은 8.1% / 3.3%에 그치며, 회로 형성과 정리 단계의 체크포인트는 그 사이에 위치합니다.
- 언러닝이 공유 회로를 파괴: 그로킹 모델에서 RL 언러닝은 FVE를 0.97에서 0.33으로 떨어뜨리고 제한 손실을 0 근처에서 2.44로 올리지만, 암기 모델에서는 둘 다 변화가 없습니다. 핵심 푸리에 방향의 그래디언트를 필터링하면 보존 정확도가 8.1%에서 30.6%로 상승하여, 회로 손상이 보존 손상에 인과적으로 기여함을 보여줍니다.
- 스펙트럼 전반에 걸쳐 거의 단조적인 경향: BMA에서 Pf = 0.1 시점의 보존 손상 1 − Pr은 암기 하한이 0에서 8비트로 증가함에 따라 감소하며, 모든 방법(GD, RL, DPO, ME)과 모든 삭제 비율(1%, 5%, 10%)에서 Spearman 상관계수가 −0.9 또는 −1.0입니다.
- 언어적 규칙성이 원문 재현을 지배: 희귀 어휘가 많은(TF-IDF가 높은) 지문은 추정 하한이 높으며, High 세트를 언러닝하면 두 Hubble-8B 모델의 모든 방법에서 Low 세트보다 ID 손상이 적습니다(예: 500B에서 GA 14.8 vs. 26.4 pp). 또한 분포 외(OOD) 지문보다 분포 내(ID) 지문에서 손상이 더 큽니다.
- 의미적 규칙성이 사실 재현을 지배: 예측 가능한 속성(이메일, 국적; 0.43–1.61비트)은 36–46 pp의 동일 관계 손상을 입지만, 예측 불가능한 속성(출생지, UUID; 2.30–5.70비트)은 13–16 pp에 그치며, 하한이 커질수록 동일 관계/타 관계 손상 격차가 줄어듭니다.
- 제거된 확률이 어디로 가는지가 중요: 확률 질량을 규칙에 부합하는(버킷 내) 대안으로 재배치하면 보존 정확도 71–76%를 유지하지만 임의의 타깃으로 보내면 15–28%에 그치며, 삭제 버킷 정확도는 100%에 가깝게 유지됩니다.
의의
본 연구는 오랫동안 관찰되었지만 제대로 이해되지 않았던 현상, 즉 언러닝이 왜 보존해야 할 것까지 그토록 자주 손상시키는가에 대한 원리적 설명을 제공합니다. 보존 손상을 학습 과정에서의 일반화 의존도와 연결함으로써, 언러닝의 어려움을 언러닝 알고리즘만의 속성이 아니라 학습 역학의 속성으로 재정의합니다. 암기 하한은 참조 모델을 통해 실제 LLM에서도 계산할 수 있는 구체적이고 측정 가능한 양으로, 특정 삭제 요청이 얼마나 큰 비용을 초래할지 사전에 예측할 수 있게 해줍니다.
연구 결과는 방법 설계에 대한 두 가지 실행 가능한 교훈도 담고 있습니다. 첫째, 기여 제거와 행동 억제는 서로 다른 목표입니다. 공유 규칙이 답변의 대부분을 설명하는 경우 재학습이라는 황금 기준조차 대상 출력을 재현하므로, 언러닝 방법은 어느 목표를 추구하는지 명시해야 합니다. 둘째, 언러닝 목적 함수는 일반화의 근간이 되는 구조를 보존하는 대안을 선호해야 합니다. 규칙에 부합하는 답변으로 확률을 재분배하거나, 참조 모델이 이미 예측하지 못하는 토큰에 억제 가중치를 집중하면 부수적 손상이 크게 줄어듭니다. 이러한 통찰은 모델이 어떻게 학습했는지를 고려하는 것이 안전한 망각의 필수 조건임을 강조합니다.